Image
GPT Image 2.5 Sunburst Text to Image Variantes : 4
≈ 0,054 $
54 crédits API
Aucun résultat. Essayez « vidéo », « FLUX » ou « webhooks ».
Chargement des modèles…
openai/gpt-image-2.5/flare/text-to-image
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://vit.doitong.com/api/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://vit.doitong.com/api/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://vit.doitong.com/api/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://vit.doitong.com/api/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/fr-CA/developers/docs/mcp)
claude mcp add --transport http doitong-models https://vit.doitong.com/api/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
}Appelez le modèle GPT Image 2.5 Text to Image (openai/gpt-image-2.5/flare/text-to-image) par l’intermédiaire de Doitong API. Documentation pour les agents : https://doitong.com/fr-CA/developers/models/openai/gpt-image-2.5/flare/text-to-image.md
POST https://vit.doitong.com/api/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
Si l’état de la réponse est "queued" ou "running", interrogez GET https://vit.doitong.com/api/v1/requests/REQUEST_ID?wait=20 jusqu’à ce qu’il soit "succeeded"; les fichiers se trouvent dans outputs[].url. POST https://vit.doitong.com/api/v1/quote/openai/gpt-image-2.5/flare/text-to-image avec le même corps renvoie le prix exact avant l’exécution.Cette requête: 0,013 $ 13 crédits API L’exécuter sur cette page
Votre nouvelle clé API. Elle est affichée uniquement maintenant et figure déjà dans le code et dans le champ de clé API ci-dessous. Gardez-la secrète : ne la mettez jamais dans du code qui s’exécute dans un navigateur.
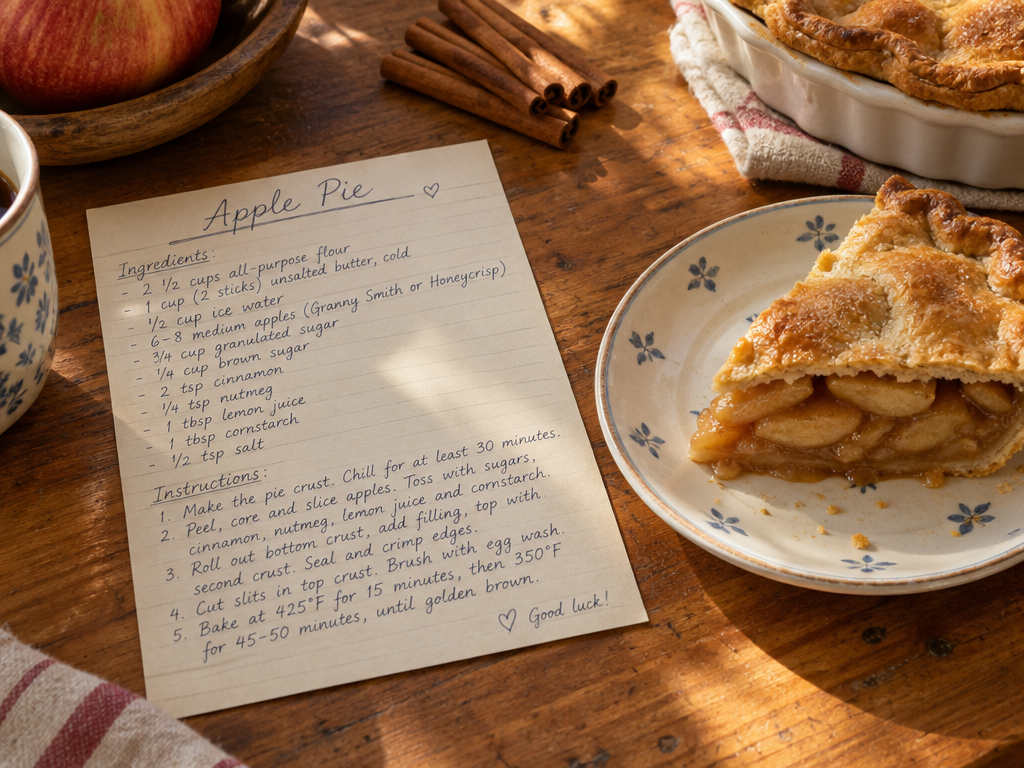
Les contrôles sont générés à partir du schéma du modèle. Le code et le prix se mettent à jour au fur et à mesure de vos modifications.
/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
devis → 0,013 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://vit.doitong.com/api/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://vit.doitong.com/api/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://vit.doitong.com/api/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://vit.doitong.com/api/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
},
"wait_seconds": 20
}
}
}Votre clé reste dans ce navigateur : elle est envoyée uniquement au Doitong API et enregistrée dans localStorage uniquement si vous cochez Mémoriser. Obtenir une clé API
Générateur d’images polyvalent d’OpenAI : il suit des instructions longues et précises, organise proprement le texte et les diagrammes et peut retourner des fichiers PNG ou WebP avec un arrière-plan transparent pour les autocollants, les icônes et les détourages de produits. Cinq niveaux de qualité permettent de privilégier la vitesse et le prix ou les détails. Les tailles vont jusqu’à 3840 px sur le côté le plus long (multiples de 16, au plus 3:1); jusqu’à dix images par requête.
Envoyez soit le nom canonique, soit le nom natif, mais pas les deux. Noms canoniques
promptrequis
image_sizefacultatif
backgroundfacultatif
qualityfacultatif
num_imagesfacultatif
num_outputs
output_formatfacultatif
output_compressionfacultatif
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "openai/gpt-image-2.5/flare/text-to-image",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 13,
    "usd": "0.013",
    "charged": 13,
    "refunded": 0
  },
  "input": {
    "prompt": "A flat vector sticker of a smiling cactus wearing sunglasses, thick white outline, no background",
    "image_size": "square_hd",
    "quality": "medium",
    "background": "transparent"
  },
  "output": {
    "images": [
      {
        "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
        "content_type": "image/jpeg",
        "file_name": "0-output.jpeg",
        "file_size": 1843200,
        "width": 1024,
        "height": 768
      }
    ]
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://vit.doitong.com/api/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://vit.doitong.com/api/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}
Pour les agents IA : cette page en Markdown se trouve à https://doitong.com/fr-CA/developers/models/openai/gpt-image-2.5/flare/text-to-image.md. Tous les modèles et guides : https://doitong.com/developers/llms.txt