Wideo
Kling Video V3 Text to Video 4K Warianty: 6
0,42 $ / sekunda
420 kredytów API / sekunda
5 s ≈ 2,10 $
Brak wyników. Spróbuj „video”, „FLUX” lub „webhooks”.
Ładowanie modeli…
kling-video/v3/pro/text-to-video
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://vit.doitong.com/api/v1/run/kling-video/v3/pro/text-to-video?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
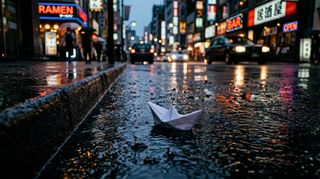
    "prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
    "duration": 5,
    "generate_audio": false,
    "aspect_ratio": "16:9"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://vit.doitong.com/api/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://vit.doitong.com/api/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/kling-video/v3/pro/text-to-video?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
"duration": 5,
"generate_audio": false,
"aspect_ratio": "16:9"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://vit.doitong.com/api/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
"duration": 5,
"generate_audio": False,
"aspect_ratio": "16:9",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/kling-video/v3/pro/text-to-video", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/pl/developers/docs/mcp)
claude mcp add --transport http doitong-models https://vit.doitong.com/api/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "kling-video/v3/pro/text-to-video",
"input": {
"prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
"duration": 5,
"generate_audio": false,
"aspect_ratio": "16:9"
}
}Wywołaj model Kling 3.0 Pro Text to Video (kling-video/v3/pro/text-to-video) za pośrednictwem Doitong API. Dokumentacja dla agentów: https://doitong.com/pl/developers/models/kling-video/v3/pro/text-to-video.md
POST https://vit.doitong.com/api/v1/run/kling-video/v3/pro/text-to-video?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
"duration": 5,
"generate_audio": false,
"aspect_ratio": "16:9"
}
Jeśli status odpowiedzi to "queued" lub "running", odpytuj GET https://vit.doitong.com/api/v1/requests/REQUEST_ID?wait=20, aż status zmieni się na "succeeded"; pliki znajdują się w outputs[].url. POST https://vit.doitong.com/api/v1/quote/kling-video/v3/pro/text-to-video z tym samym ciałem zwraca dokładną cenę przed uruchomieniem.To żądanie: 0,56 $ 560 kredytów API Uruchom na tej stronie
Twój nowy klucz API. Jest wyświetlany tylko teraz i znajduje się już w kodzie oraz w polu klucza API poniżej. Zachowaj go w tajemnicy: nigdy nie umieszczaj go w kodzie uruchamianym w przeglądarce.
PromptA paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.
Elementy sterujące są generowane ze schematu modelu. Kod i cena aktualizują się podczas ich zmiany.
/run/kling-video/v3/pro/text-to-video?wait=20
wycena → 0,56 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://vit.doitong.com/api/v1/run/kling-video/v3/pro/text-to-video?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
    "duration": 5,
    "generate_audio": false,
    "aspect_ratio": "16:9"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://vit.doitong.com/api/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://vit.doitong.com/api/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/kling-video/v3/pro/text-to-video?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
"duration": 5,
"generate_audio": false,
"aspect_ratio": "16:9"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://vit.doitong.com/api/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
"duration": 5,
"generate_audio": False,
"aspect_ratio": "16:9",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/kling-video/v3/pro/text-to-video", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "kling-video/v3/pro/text-to-video",
"input": {
"prompt": "A paper boat drifts down a rain-filled street gutter at dusk. The camera follows at water level as raindrops ripple around it and neon reflections shimmer on the wet asphalt, then the boat tips over a small cascade into a puddle. Realistic water physics, shallow depth of field, cinematic.",
"duration": 5,
"generate_audio": false,
"aspect_ratio": "16:9"
},
"wait_seconds": 20
}
}
}Klucz pozostaje w tej przeglądarce: jest wysyłany tylko do Doitong API i zapisywany (localStorage) tylko po zaznaczeniu opcji Zapamiętaj. Uzyskaj klucz API
Flagowy model Kling text-to-video renderuje płynny, fizycznie wiarygodny ruch i filmowe oświetlenie, a Domyślnie generuje dopasowany dźwięk i mowę. Podziel jeden klip na kilka ujęć za pomocą promptów dla poszczególnych ujęć albo Pozwól modelowi samodzielnie zaplanować cięcia. 16:9, 9:16 lub 1:1, dowolna długość od 3 do 15 sekund, z promptem negatywnym i skalą zgodności.
promptopcjonalne
durationopcjonalne
multi_promptopcjonalne
multi_prompt[].promptwymagane
multi_prompt[].durationopcjonalne
generate_audioopcjonalne
shot_typeopcjonalne
aspect_ratioopcjonalne
negative_promptopcjonalne
cfg_scaleopcjonalne
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "kling-video/v3/pro/text-to-video",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 560,
    "usd": "0.56",
    "charged": 560,
    "refunded": 0
  },
  "input": {
    "prompt": "Close-up of fireflies dancing in a dark forest at twilight, soft glowing particles, slow dolly forward",
    "duration": 5,
    "aspect_ratio": "16:9"
  },
  "output": {
    "video": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.mp4",
      "content_type": "video/mp4",
      "file_name": "0-output.mp4",
      "file_size": 1843200
    }
  },
  "outputs": [
    {
      "type": "video",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.mp4",
      "content_type": "video/mp4",
      "file_size": 1843200,
      "width": 1280,
      "height": 720,
      "duration": 5,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://vit.doitong.com/api/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://vit.doitong.com/api/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}
Dla agentów AI: ta strona w formacie Markdown jest dostępna pod adresem https://doitong.com/pl/developers/models/kling-video/v3/pro/text-to-video.md. Wszystkie modele i przewodniki: https://doitong.com/developers/llms.txt